// Compute & Storage Foundation
Topologie uzlu
GeForce RTX 5060 Ti
Masivní paralelní akcelerátor osazený 4 864 CUDA jádry pro hrubý výpočetní výkon a 152 Tensor jádry 5. generace s plnou hardwarovou podporou formátu FP4 / FP8 a Transformer Engine pro akceleraci inference bez ztráty přesnosti. Jádro pracuje na základní frekvenci 2 115 MHz a stabilním Boost taktu 2 535 MHz, generujícím AI výkon přes 390 TFLOPS. Architektura Blackwell kompletně přechází na paměťový standard 16GB GDDR7 běžící na efektivním kmitočtu 28 Gbps s pokročilým kódováním signálu PAM3. Přes 128-bit sběrnici dosahuje celková propustnost paměťového subsystému masivních 448 GB/s (nárůst o 55 % oproti předchozí generaci Ada Lovelace). Tato synergie hardwaru spolehlivě zabraňuje Out-Of-Memory chybám při skládání obřích difuzních matic v ComfyUI a odstraňuje ořezávání kontextových oken u velkých LLM modelů do velikosti 14B při úsporném TDP 175 W.
Intel Core i7-8700
Procesor architektury Coffee Lake (14nm) s 6 fyzickými jádry a 12 vlákny. Základní takt 3.20 GHz automaticky stoupá v Turbo Boost režimu až na 4.60 GHz (12MB Intel Smart Cache). Integrované grafické jádro Intel UHD Graphics 630 kompletně přebírá zobrazování hostitelského OS Ubuntu 26.04 LTS, čímž ponechává kompletní kapacitu a výkon 16GB GDDR7 paměti Blackwell karty k výhradní alokaci vah lokálních AI modelů.
Disková pole SMR & M.2 Cache
Systémová cache webe běží na ultra-rychlém PC801 SK hynix (512GB). Jedná se o M.2 NVMe disk (PCIe Gen4 x4) s propustností čtení až 7 000 MB/s pro swapování vah do VRAM. Trvalý datový prostor tvoří pole disků WDC WSH722870AL, které využívají technologii SMR (šindelový magnetický zápis) pro maximalizaci hustoty stop překrýváním přes sebe. Datový tok řídí řadiče SAS3008 Fusion-MPT (HBA330) a 3ware 9650SE SATA-II RAID PCIe.
S.M.A.R.T. Scrutiny
Zdraví, bloková integrita a provozní teploty celého šindelového magnetického fondu jsou kontinuálně monitorovány izolovaným démonem Scrutiny.
Srovnání rychlosti inference (Llama 3 - 8B Model)
Rychlost zpracování tokenů za sekundu (t/s) při INT4/FP16 optimalizaci vah u top 10 běžných PCIe karet. Vyšší hodnota znamená bleskovější odpověď modelu.
// Ollama LLM Kernel
Lokální Jazykový Registr
Uvažující model. Využívá pokročilé vnitřní řetězce (Chain-of-Thought) k logické analýze.
Model specializovaný na programování, komplexní více-souborové refaktorování a debugging kódu.
Špičkové open-weights modely. Výborná čeština, masivní slovník tokenů a vysoká rychlost generování.
Vysoce logicky saturovaný model trénovaný na syntetických datech. Exceluje v přesných faktických odpovědích.
Základní pilíř open-source. Multimodální verze integruje optické vrstvy pro analýzu nahraných grafů a obrázků.
Podnikový model optimalizovaný pro korporátní datasety, finanční analýzy a strukturovanou práci s textem.
Asijská řada modelů disponující velkým oknem kontextu a výborným sémantickým porozuměním strukturám.
Nezávislé komunitní váhy udržované open-source vývojáři pro testování alternativních typů kvantizací.
// ComfyUI Synthesis Core
Vizuální pipeline & interaktivní náhledy
Hlavní generátory a alternativy
Základní neuronové váhy. Přejděte myší nad zvýrazněné názvy pro zobrazení stylu modelu:
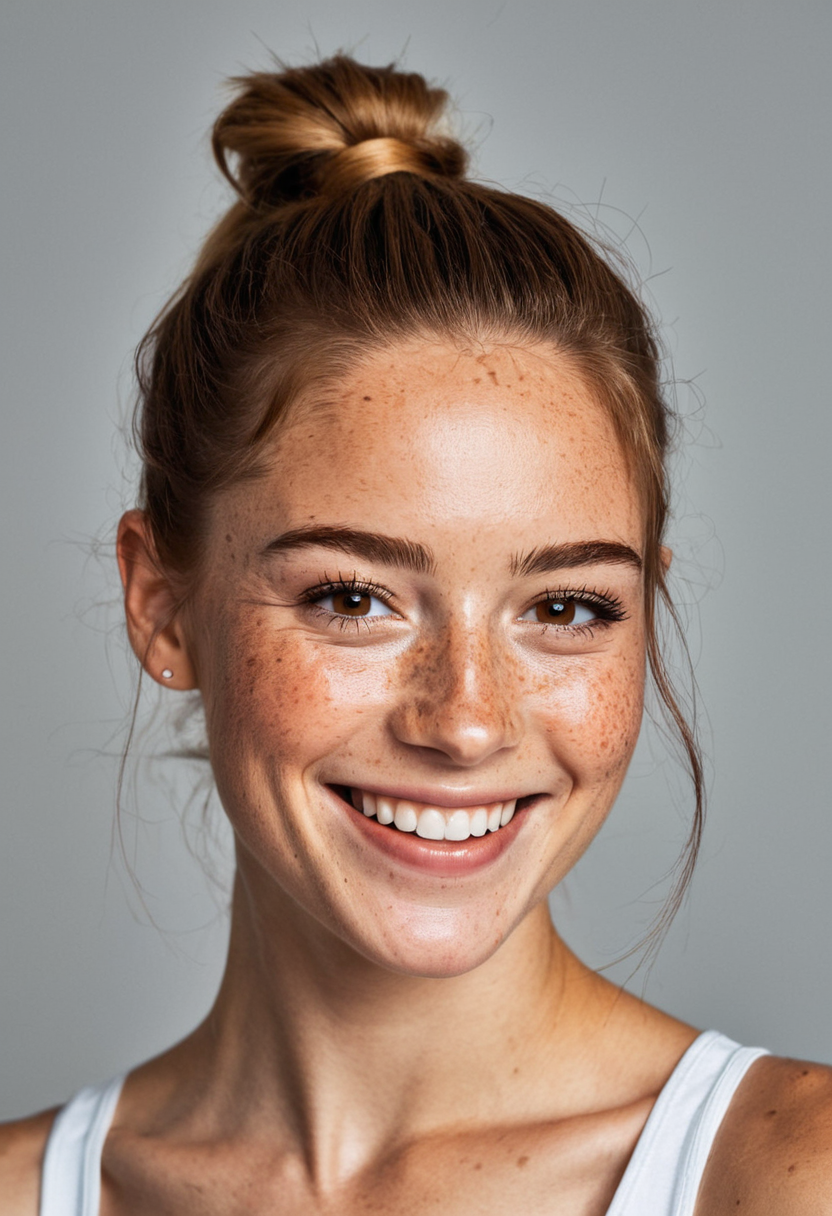
Klady: Nekompromisní fotorealismus, dokonalá lidská kůže a filmové stíny.
Zápory: Slabší fantasy art.
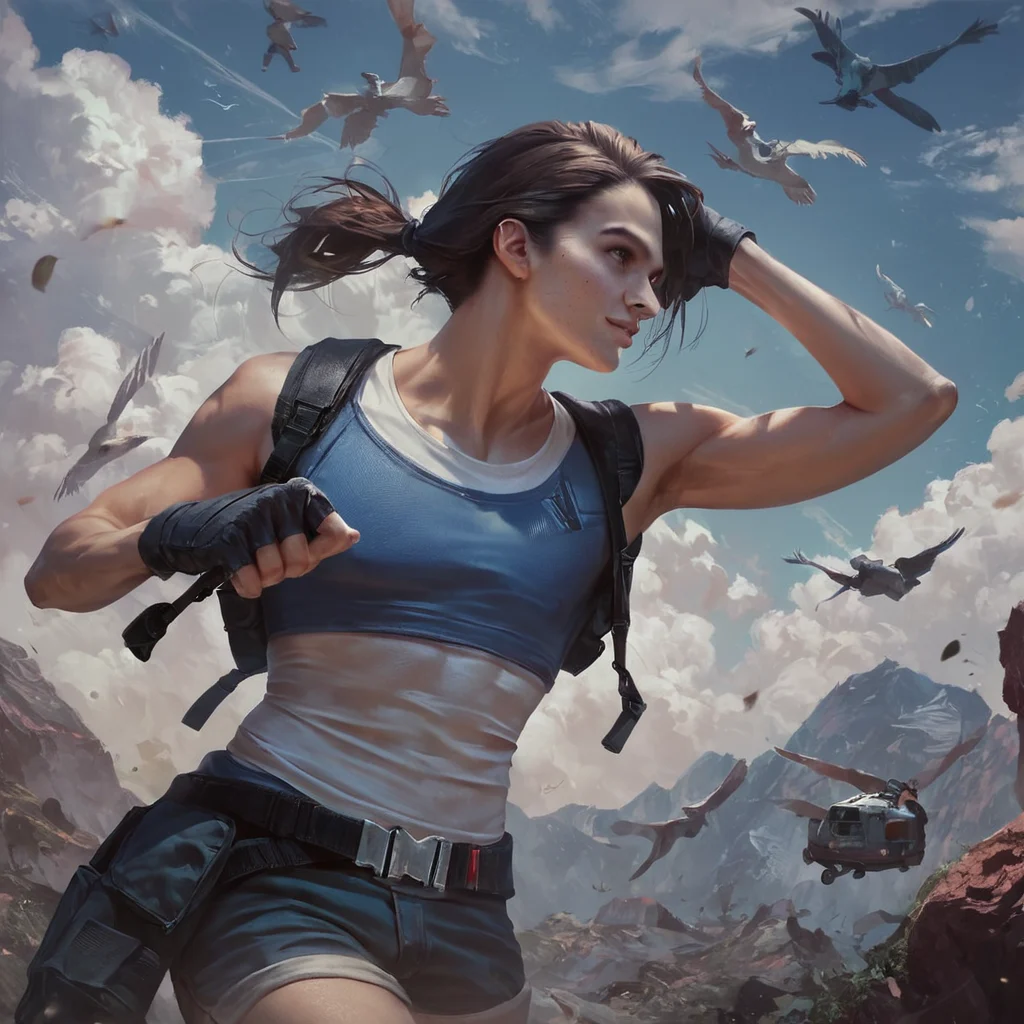
Klady: Stoprocentní plnění složitých promptů, anime, ilustrace a čistý 2D/3D art.
Zápory: Neumí reálné fotky.
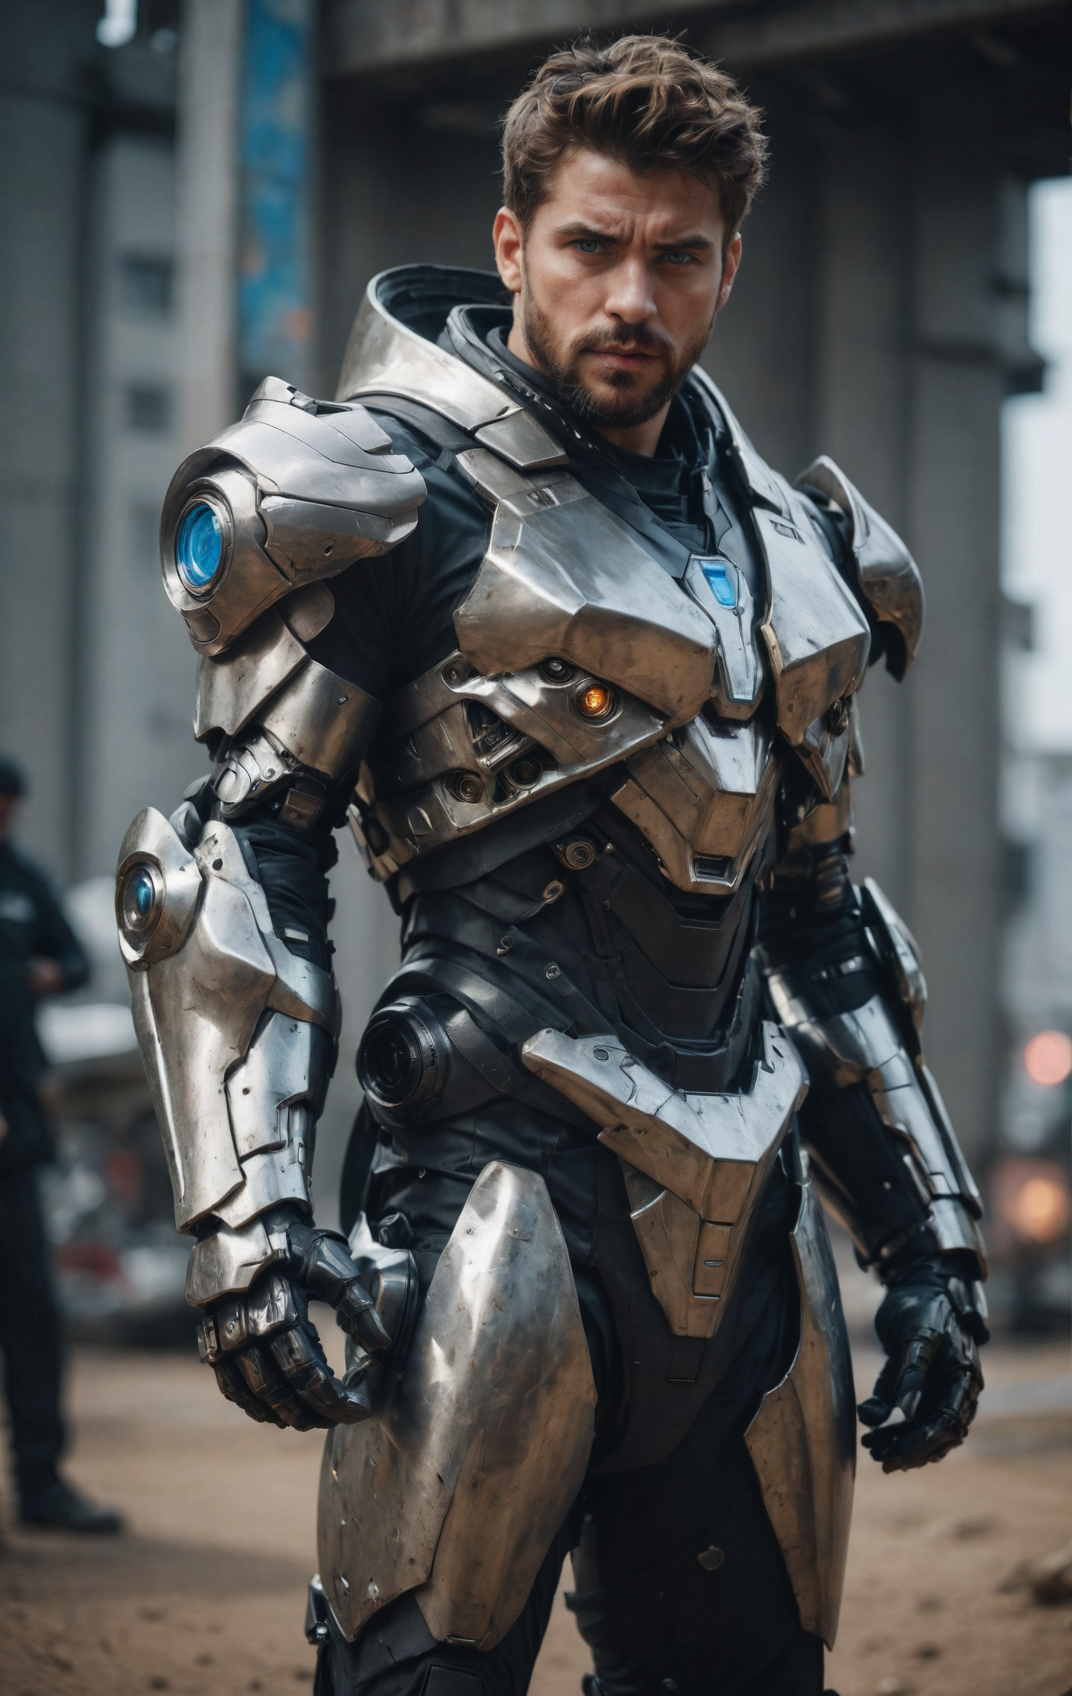
Klady: Úžasný poměr mezi realismem a malbou, ideální na fantasy koncepty.
Zápory: Obličeje v dálce vyžadují upscaler.
LoRA Adaptéry
Přídavné mikromodely pro okamžité ohnutí stylu checkpointu. Najetím vyvoláte grafický výstup:
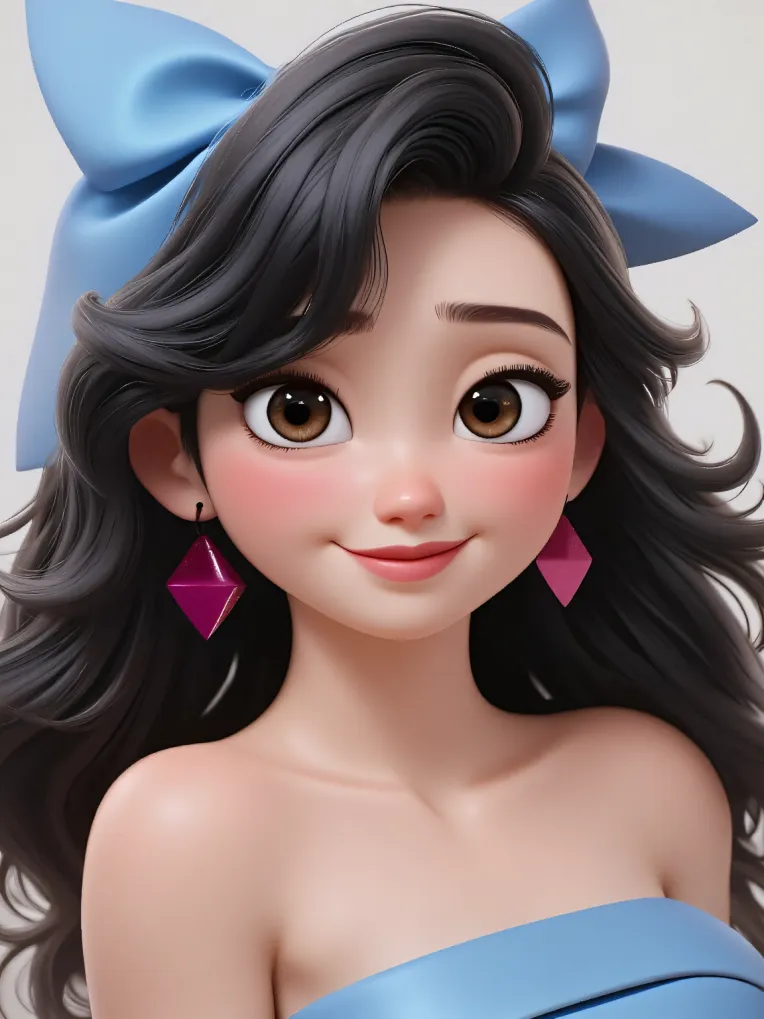
Řízení struktur, vektorů a autoenkodérů
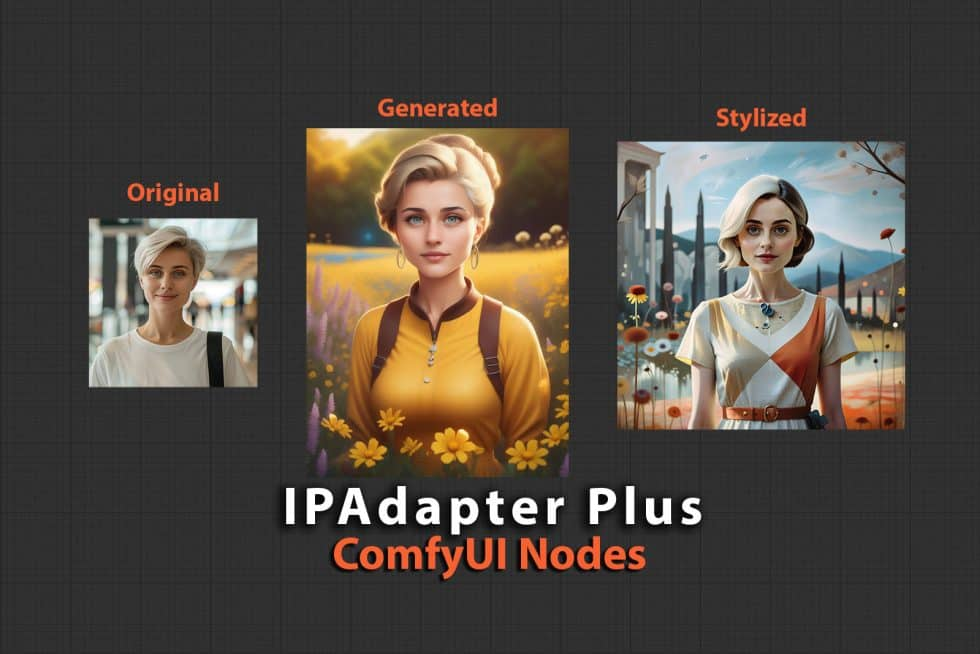
Izolované překreslování a úpravy vybraných oblastí obrazu pomocí masky.
Generování lokálních video sekvencí se zachováním časové provázanosti pixelů.
// Knowledge Base
Globální & Lokální AI Ekosystém
🤗 Hugging Face
Úložiště GGUF modelů do Ollamy.
🎨 Civitai
Komunitní ráj pro Stable Diffusion checkpointy.
🦙 Ollama Models
Registr optimalizovaných textových vah modelů.
🔥 AICrunch
Přední český zpravodajský portál zaměřený na nejnovější technologické trendy, open-source komunitu a vývoj v oblasti AI.
🧠 Umeligence
Český výukový a informační hub specializovaný na hluboké návody, prompt engineering a praktické nasazení AI nástrojů.
🐙 GitHub AI
Zdrojové kódy pro custom uzly ComfyUI.